


✨︎ Resumen (TL;DR):
- Frank Chu ejecutó en la CPU de su computadora el código y las muestras preparados por Will DePue y obtuvo los mismos resultados de la tabla del repositorio.
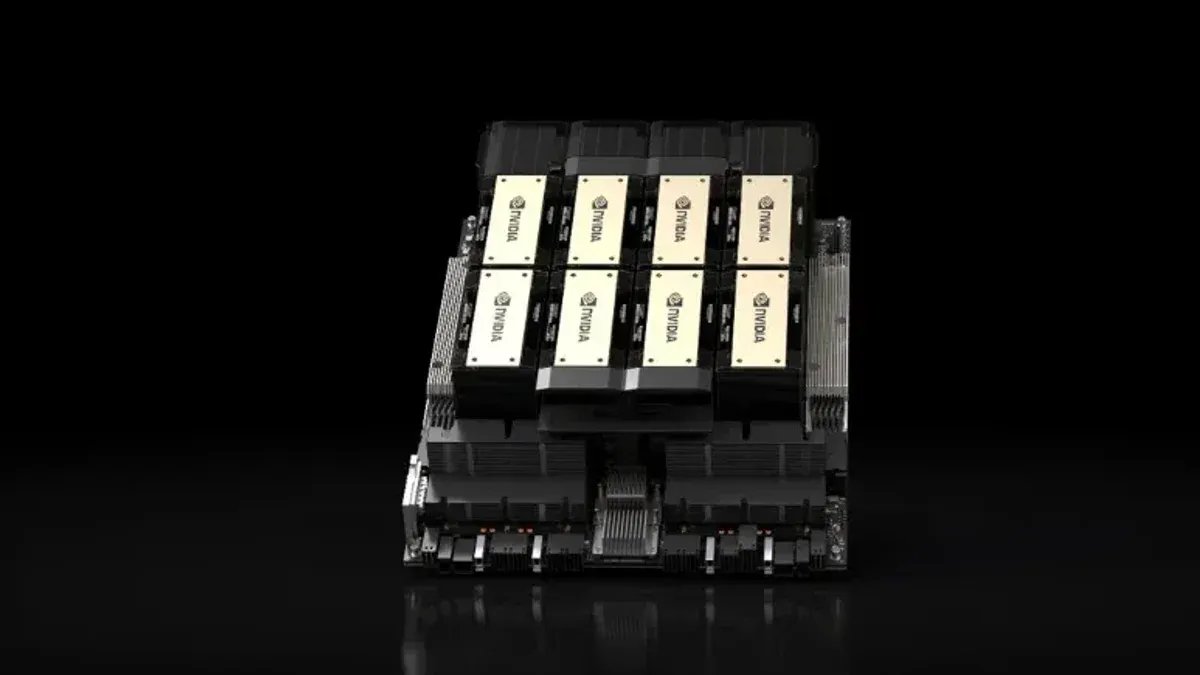
- El informe estima unas 12,000 GPU Blackwell para cinco entrenamientos, con un intervalo de 7,000 a 22,000.
- La ejecución no confirma dónde se entrenaron los modelos, cuántos chips se usaron ni que existieran 12,000 chips distintos.
Frank Chu, autor en DEV Community, afirmó el 13 de noviembre que reprodujo en su computadora parte de las pruebas con las que Will DePue relacionó modelos chinos de IA con chips Nvidia Blackwell. Obtuvo la misma salida del código y las muestras del investigador, pero el resultado no verifica qué hardware se usó durante el entrenamiento ni confirma el cálculo de 12,000 GPU.
Chu publicó el resultado un día después del informe de Unemployment Labs. En ese trabajo, DePue examinó los pesos publicados de seis modelos de DeepSeek, Moonshot AI, MiniMax y Ant Group. Encontró patrones compatibles con Nvidia Blackwell, chips sujetos a controles estadounidenses de exportación hacia China.
La huella de pesos es un patrón en los valores iniciales de un modelo que sirve para comparar resultados producidos por distintos chips. La investigación original advertía que esas señales corresponden a la creación de los valores iniciales y que los equipos de esa etapa podrían ser distintos de los que después realizaron el entrenamiento.
La reproducción cubrió solo el paquete disponible
Chu escribió que ejecutó en la unidad central de procesamiento, o CPU, de su computadora el programa compartido por DePue y obtuvo los mismos resultados que aparecen en la tabla del repositorio. Usó el código y las muestras preparados por el propio investigador.
El relato no documenta que haya repetido el análisis completo con todos los modelos originales ni que haya hecho una nueva prueba con las GPU físicas. La coincidencia de la salida indica que pudo repetir esa comprobación con el paquete disponible, no toda la investigación.
El paquete contiene muestras de cinco modelos:
- DeepSeek-V4-Flash, Kimi K3, MiniMax-M3 y Ling-3.1-flash: cuatro pertenecen al grupo que el informe asocia con Blackwell.
- DeepSeek-V3: un modelo anterior que sirve de comparación y cuya señal corresponde a la generación Hopper, según el repositorio.
El informe original menciona seis modelos con señales compatibles con Blackwell. DeepSeek-V4-Pro y Kimi K3.1-Pro no figuran entre los cinco casos del paquete que Chu dice haber ejecutado.
El repositorio incluye filas de pesos copiadas de modelos publicados y un programa que busca las configuraciones que producen patrones coincidentes. Repetir la salida no verifica dónde se entrenaron los modelos ni cuántos chips participaron.
Los 12,000 GPU son una estimación
DePue calculó cuánta capacidad podría haberse necesitado para entrenar cinco modelos. Su estimación central suma unas 12,000 GPU Blackwell al considerar las cinco ejecuciones, con un intervalo de 7,000 a 22,000. El propio investigador señaló que no tiene confianza en esas cifras.
Para Kimi K3, calculó alrededor de 4,500 GPU, con un rango de 1,000 a 9,500. Para DeepSeek-V4-Pro, estimó unas 3,000 GPU, dentro de un rango de 750 a 6,500.
Son cálculos para cada entrenamiento, no un recuento de equipos encontrados. Tampoco prueban que existieran 12,000 chips distintos o que todos se usaran al mismo tiempo.
El resultado depende de variables que las huellas no pueden confirmar: la eficiencia de los procesadores, la cantidad de información usada para entrenar algunos modelos, la duración de cada ejecución y el supuesto de que el entrenamiento se mantuvo en el mismo tipo de hardware que creó los valores iniciales.
El tiempo cambia especialmente la estimación. Si se reduce a la mitad la duración supuesta de una ejecución y se mantienen las demás condiciones, la cantidad de GPU estimada se duplica. El programa que Chu ejecutó no mide esas variables ni reproduce el cálculo de escala.
El informe fue revisado el 12 de noviembre. Su primera versión estimaba entre 2,000 y 3,000 GPU para cada uno de los entrenamientos más grandes; el autor elevó después las cifras al cambiar sus supuestos de eficiencia. Esa revisión explica por qué algunas coberturas citan cantidades distintas.
La huella no ubica los chips
En sus propias pruebas, DePue informó que una B300 reprodujo los valores iniciales de DeepSeek-V4-Flash y que una GB200 reprodujo los de Kimi K3. También examinó una alternativa: una GPU AMD MI300X configurada de cierta manera puede producir patrones similares.
El informe dice que una comparación adicional favoreció a Nvidia para V4-Flash, pero no resolvió del mismo modo los otros cinco casos.
Ni la prueba descrita por Chu ni el informe identifican la ubicación de los chips, quién los poseía o cómo se obtuvo acceso a ellos. Tampoco establecen que se hayan infringido los controles de exportación.
Para convertir la estimación en un recuento harían falta datos adicionales sobre los entrenamientos y los equipos utilizados. La repetición descrita por Chu solo muestra que el paquete disponible produce la salida reportada; no establece cuántos chips se usaron ni si el hardware asociado con esa señal también participó en el entrenamiento.
El dato de 12,000 GPU sigue siendo una estimación con amplio margen de incertidumbre, no un inventario confirmado. La ejecución que Chu describió no cambia ese límite.


